生成AI検索の普及により、自社の情報がAIにどう引用されるかが集客と信頼の両面を左右する時代になりました。AI引用の正確性を担保するには、発信側の情報設計(構造化データ・E-E-A-T・一次情報の明示)と、利用側のファクトチェック体制の両輪が欠かせません。本記事では、AIに正しく引用されるための具体的な7つの方法と、AIの回答を自分で検証する手順、自社の引用状況を確認する方法までを一次情報とともに解説します。
- AIに正しく引用されるための情報設計7つの具体策
構造化データ・E-E-A-T・一次情報の明示など、発信側が今日から着手できる方法を体系的に整理しています。
- AIの引用結果を自分で検証するファクトチェック手順
一次情報の探し方やクロスチェックの方法など、利用側が実践できる具体的なステップを紹介します。
- 自社サイトの引用状況を確認する実践的な方法
ChatGPTやPerplexityへの直接質問からAI経由流入の計測まで、定点観測の手順を解説します。
なぜ今「AI引用の正確性」が問われているのか
生成AI検索が回答の根拠として企業情報を引用する場面が急増しており、その引用が不正確であれば誤情報の拡散や意思決定の誤りに直結するためです。PKSHAの調査では、FAQ導入企業約500社に対するAIからの参照数が2025年9月から急増し、12月には9月の2.5倍にあたる月1億5000万件を超えたと報告されています(PKSHA Technology)。この規模感からも、AIが自社情報をどう扱うかが企業の情報発信において無視できない論点になっていることがわかります。
生成AI検索普及とAI経由流入の急拡大
AIによる情報参照は短期間で急拡大しており、従来のSEOだけでは想定できなかった流入経路が主要チャネルになりつつあります。ChatGPTやPerplexity、Google AI Overviewsなどのユーザーは、検索結果一覧ではなくAIが要約した回答をそのまま受け取ることが多く、企業サイトへの訪問前にAIの回答だけで意思決定を終えるケースも増えています。この構造変化により、AIに引用される情報そのものの正確性が、検索順位以上に重要な評価軸になりつつあります。
AIが引用を誤ると何が起きるか
AIの引用ミスは誤情報の拡散だけでなく、ブランド毀損や法的リスク、利用者の意思決定の誤りにまで発展する可能性があります。ELNETのコラムでは、海外で弁護士が実在しない判例をAIで生成し裁判所に提出した事例や、航空会社の公式AIチャットボットが誤った案内をした事例が紹介されています(ELNET)。こうした事例は、AIの回答をそのまま信じて業務や顧客対応に用いることの危うさを示しています。
SEOだけでは足りない時代へ:GEO/AIO/LLMOとの関係整理
結論として、従来のSEOに加えてGEO(生成エンジン最適化)・AIO・LLMOといった、AIに正しく引用されるための最適化の観点が必要になっています。これらは検索順位を上げる従来型のSEOとは異なり、AIが情報を理解し引用しやすい形に情報を整える取り組みです。詳しい定義や違いはLLMOとは何かやGEOとSEOの違いで整理していますので、あわせて確認いただくと理解が深まります。
| 観点 | 従来のSEO | GEO/AIO/LLMO |
|---|---|---|
| 最適化対象 | 検索エンジンの順位 | AIの回答・引用 |
| 評価される単位 | ページ全体 | 意味のあるまとまり(段落・FAQ単位) |
| 重視される要素 | 被リンク・キーワード | 構造化データ・一次情報・権威性 |
| 成果指標 | 検索順位・クリック数 | 引用回数・AI経由の受注 |
TechSuite株式会社の「AI検索パートナーズ」は、自社サイトにおけるAI Share of Voiceが高水準で推移しており、支援先でもAI Overviewsの引用率を改善した実績があります。こうした定点観測の知見をもとに、AIが実際にどのように情報を扱っているかを踏まえた最適化を提案できる点が特徴です。
AI経由の流入が急増する今こそ、引用の正確性を見直す好機だと言えるでしょう
AI引用の正確性が崩れる仕組みとは
AI引用の正確性が崩れる主な要因は、AI自体が事実に基づかない内容を生成する「ハルシネーション」と、引用元が示されていても内容が正しく裏付けられていない「引用のズレ」の2つです。両者は別の問題であり、対策も異なります。まずそれぞれの仕組みを理解することが、正確な情報設計への第一歩になります。
ハルシネーションとは何か
ハルシネーションとは、AIが事実に基づかない情報をもっともらしく生成してしまう現象のことです。ハルシネーションには学習データ内の矛盾に起因する内在的なものと、学習データにない情報を外部から補おうとして生じる外在的なものの2タイプがあると整理されています。生成AIは統計的にもっともらしい文章を作る仕組みであるため、事実確認の機構を組み込まない限り誤りを完全に防ぐことは難しいとされています。
「引用元があるから正しい」とは限らない
引用元が明記されていても、その内容が本当に引用元によって裏付けられているとは限りません。Stanford大学中心の研究チームによるSourceCheckup研究では、LLM応答の50〜90%が引用ソースによって完全には支持されておらず、Web検索付きのGPT-4oでも約30%の文が引用元によって裏付けられていなかったと報告されています(medicolle)。この結果は、出典表示があること自体を正確性の証明とみなす危うさを示しています。
AI Overviewsの引用ソース選別傾向
AIは情報源を選ぶ際に、機関的な権威性や専門家監修の有無といったシグナルを重視する傾向があります。medRxivに公開された研究では、ChatGPT 5.2 Proに100の消費者向け健康質問を入力し引用された615ソースを分析した結果、75%以上がMayo ClinicやCleveland Clinic、NHS、PubMedなど機関的に確立された情報源から来ていたと報告されています(medicolle)。一方でSE Ranking社の分析では、ドイツ語のAI Overviews約46万件のうち「より信頼できる医療情報源」と分類されたのは34.45%にとどまり、残り65.55%は医学的正確性の基準に従って設計されていないソースから引用されていたとも報告されており、AIの選別が常に理想的とは限らない実態がうかがえます(medicolle)。
| 研究・調査 | 対象 | 主な結果 |
|---|---|---|
| SourceCheckup研究 | LLM応答の引用裏付け | 応答の50〜90%が引用元に完全支持されず |
| medRxiv (Jacques et al.) | ChatGPT 5.2 Proの健康質問 | 引用の75%以上が機関的情報源から |
| SE Ranking社分析 | 独語AI Overviews約46万件 | 信頼できる医療情報源は34.45%のみ |
| The Guardian調査報道 | 健康関連クエリのAI Overviews | Googleが一部応答を削除する措置 |
TechSuite株式会社の「AI検索パートナーズ」は、生成AIが引用・推薦する仕組みを構造化データ・意味的文脈・エンティティ認識・想定質問の分解といった観点から技術的に捉え、LLMO/GEO/AEOの施策に落とし込む形で支援しています。仕様変化にも研究データをもとに追従できる体制を整えている点が特徴です。
出典があるからと油断せず、引用の裏付けまで見る視点を持ちたいところです
AI検索パートナーズでは、
AIに”選ばれる”ための戦略設計から実行まで支援!
AI引用の正確性を担保する方法7選
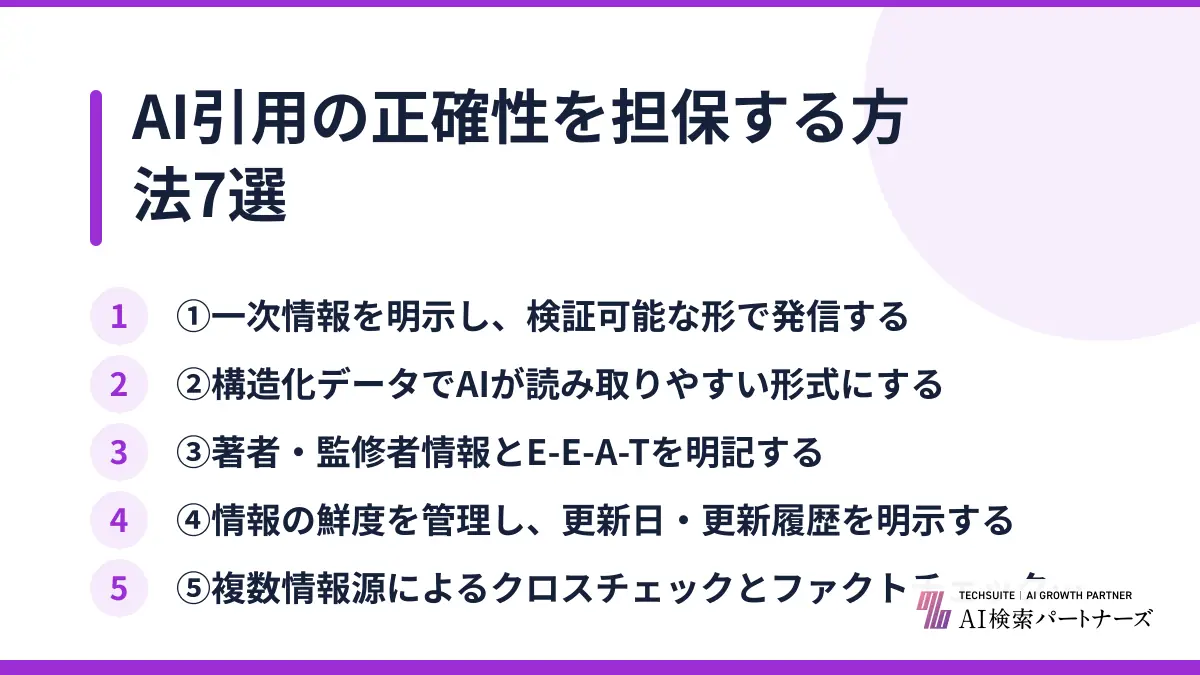
AI引用の正確性を担保するには、一次情報の明示・構造化データ・著者情報の開示・鮮度管理・クロスチェック体制・技術的な精度担保・透明性の確保という7つの方法を組み合わせることが有効です。それぞれ発信側と技術側の両面から具体的に見ていきます。
①一次情報を明示し、検証可能な形で発信する
AIに正しく引用されるための土台は、伝聞や推測ではなく検証可能な一次情報を明示することです。統計値や調査結果を扱う際は、調査主体・調査時期・対象範囲を明記し、可能であれば出典元へのリンクを添えることが望まれます。一次情報が明確なコンテンツは、AIが根拠として参照しやすいだけでなく、読者自身が事実確認をしやすいという副次的な効果もあります。
②構造化データでAIが読み取りやすい形式にする
schema.orgに基づくFAQスキーマや記事構造化データを実装することで、AIが情報の意味的なまとまりを機械的に理解しやすくなります。EBSCOは、LLMがナレッジグラフの形でリンクトデータに接続されると回答精度が54%向上し、同時にハルシネーションの可能性が減少することが実証されていると紹介しています(EBSCO)。構造化データはAIにとっての「読み解きやすさ」を高める仕組みであり、正確な引用の前提条件になります。
③著者・監修者情報とE-E-A-Tを明記する
専門家による監修表記は、AIが情報源を選ぶ際の権威性シグナルとして機能すると考えられています。米RepuGen社の二次解説記事によれば、「Reviewed by Dr. [Name], MD」という医師レビュー表記は、AI健康ツールに引用されるソースの71.1%に登場しているとされています(medicolle)。医療領域に限らず、専門分野の記事には執筆者・監修者の経歴や資格を明記することが有効です。
④情報の鮮度を管理し、更新日・更新履歴を明示する
公開日だけでなく更新日と更新内容を明記することで、AIや読者に情報の鮮度を伝えやすくなります。制度や統計は年ごとに変わるため、古い情報がそのまま引用され続けると誤情報の温床になりかねません。定期的な見直しと更新履歴の記録は、地味ながら正確性担保の基礎となる作業です。
⑤複数情報源によるクロスチェックとファクトチェック体制を構築する
制作段階で複数の情報源を突き合わせるファクトチェック体制を持つことが、誤情報を発信前に防ぐ最も直接的な方法です。ベイジの図書館は「正しい記事」を正確性・独自性・読者満足度・可読性・倫理性の5条件で定義し、検証対象の洗い出しから一次情報の確認、二次情報での補強、複数情報源でのクロスチェックという手順を提示しています(ベイジ)。こうした手順を社内フローとして明文化しておくことが重要です。
⑥RAG・グラウンディングなど技術的な仕組みで生成AI自体の精度を高める
自社でAIチャットボットやRAGシステムを開発・活用する場合は、技術面での精度担保も欠かせません。グラウンディングとは、LLMの出力を外部の信頼できるデータソースと照合し、事実に基づいた回答を生成させる技術であり、RAG(検索拡張生成)はそれを実現する代表的な手法として位置づけられています(Japan AI)。あわせて、温度設定を下げる、システムプロンプトで出典明示を義務づけるといった対策だけでもハルシネーションの発生率を体感で30〜50%低減できるとされ、単一対策ではなくガードレールとハルシネーション検知モデルの併用が最も効果的とされています(AI総研)。
⑦透明性を確保する(AI利用の明記・説明可能なAI)
AIがコンテンツ制作に関与している場合はその旨を明記し、データの来歴や審査プロセスを開示する姿勢が信頼につながります。EBSCOは、データの起源・来歴・構成やソースデータの重み付け方法、専門家による審査プロセスを開示する「説明可能なAI(XAI)」を掲げ、Stanford Transparency Indexを積極的にモニターしていると説明しています(EBSCO)。一方で米健康メディアHealthlineは、すべての健康情報は人間が人間のために作成しており、生成AIツールで作成されたコンテンツは公開しないと明記しており(medicolle)、業界によっては人間による制作を明確に打ち出すことも透明性の一形態と言えます。
AI引用の正確性を担保する7つの方法を、着手しやすい順に整理しました。
- 一次情報を明示し検証可能な形で発信しているか
- schema.orgに基づく構造化データを実装しているか
- 著者・監修者情報を明記しE-E-A-Tを示せているか
- 更新日・更新履歴で情報の鮮度を管理しているか
- 複数情報源によるクロスチェック体制があるか
- RAG・グラウンディングなど技術的な精度担保を検討しているか
- AI利用の明記や説明可能なAIなど透明性を確保しているか
TechSuite株式会社の「AI検索パートナーズ」は、コンサルティングという性質上、業種・規模・商材・課題に合わせてこれら7つの方法の優先順位や実装方法をすべて個別に設計します。サイトの構造やコンテンツ運用のボトルネックを特定したうえで、解決策の提示から実行の伴走までを一貫して行える点が強みです。
7つの方法は単発ではなく組み合わせてこそ効果を発揮するものです
AI検索パートナーズでは、AIに”選ばれる”ための戦略設計から実行まで一気通貫で支援!
AI検索パートナーズでは、AI検索の専門知識と支援実績を持つ専任コンサルタントが、AIに“引用される・選ばれる”ための戦略設計からコンテンツ最適化、効果測定・改善まで一気通貫でご支援いたします。
ご興味のある方は、ぜひ資料をダウンロードして詳細をご確認ください。
【発信側】AIに正しく引用されるための情報設計チェックリスト
発信側の対策は、結論を先出しするFAQ形式の構成・独自の一次情報の掲載・第三者による監修・競合上位記事の網羅性確認という4点に集約されます。これらはいずれも今日から着手可能な、地道だが効果的な情報設計の工夫です。
FAQ形式・結論ファーストの構成にする
見出し直下で結論を先に述べ、続けて詳細を展開する構成は、AIが文章から回答候補を抜き出しやすくするための基本です。FAQスキーマと組み合わせることで、質問と回答のペアとして機械的に認識されやすくなります。ChatGPTなど生成AI検索での引用を狙う場合の具体的な施策は、ChatGPT SEOの施策でも詳しく紹介しています。
独自の一次情報・データ・事例を盛り込む
他サイトの内容を要約しただけのコンテンツは、AIにとっても読者にとっても代替可能な情報にとどまります。自社が保有する調査データやアンケート結果、業務上のノウハウなど独自性のある一次情報を盛り込むことが、AIに選ばれる情報源になるための差別化要素になります。Googleは2024年3月改訂のスパムポリシーで、検索順位操作を主目的にした大量自動生成をスパムと明確に定義しており(ベイジ)、独自性のない量産コンテンツは評価されにくい傾向が強まっています。
医師監修・専門家監修など第三者チェックを取り入れる
専門性が問われる領域では、社内執筆者だけでなく外部専門家によるレビューを経ることが信頼性の担保につながります。監修者の氏名・資格・所属を明記し、可能であれば監修コメントを掲載することで、読者とAIの双方に対する信頼シグナルとなります。
上位記事の見出しの合併集合から抜け漏れを確認する
検索上位に表示されている記事群の見出しを横断的に比較し、自社コンテンツに不足している論点がないかを確認する作業も欠かせません。AIは複数のソースから情報を合成して回答を生成するため、網羅性の低い記事は引用対象から外れやすくなります。LLMO対策の具体的なやり方では、こうした網羅性チェックの手順もあわせて解説しています。
| チェック項目 | 目的 | 実装のポイント |
|---|---|---|
| 結論ファースト構成 | AIの抜き出しやすさ向上 | 見出し直下に1〜2文で結論を配置 |
| 一次情報の掲載 | 独自性・信頼性の担保 | 調査データ・事例・出典を明記 |
| 専門家監修 | 権威性シグナルの付与 | 氏名・資格・所属を明記 |
| 網羅性の確認 | 合成回答からの脱落防止 | 上位記事の見出し合併集合と比較 |
TechSuite株式会社の「AI検索パートナーズ」は、AIを活用した高度なコンテンツ制作の仕組みを「バクヤスAI記事代行」事業で培っており、その制作エンジンとナレッジをLLMO対策に転用しています。検索意図や想定質問の分解に沿って、高品質なコンテンツを大量かつ高速に設計できる点が特徴です。
発信側の地道な情報設計こそがAIに選ばれる近道と言えそうです
【検証側】AIの回答をファクトチェックする具体的手順
AIの回答をそのまま信用せず、情報源の有無確認・一次情報との照合・複数情報源での多角的検証という3ステップで検証することが、利用側にできる最も現実的な正確性担保の方法です。ELNETのコラムでもこの3ステップが整理されています(ELNET)。
STEP1:情報源の有無を確認する
まず、AIの回答に出典や参照元が示されているかを確認します。出典が示されていない、あるいは曖昧な場合は、その時点で回答をそのまま利用しない判断が必要です。出典の有無を確認する作業は最も基本的でありながら、見落とされがちな最初の関門です。
STEP2:一次情報・信頼性の高い情報源と照合する
次に、示された出典または関連する一次情報に実際にアクセスし、内容が一致しているかを確認します。ベイジの図書館は、官公庁情報は「site:go.jp」などのサイト検索コマンド、学術論文はGoogle Scholar・J-STAGE・CiNiiでの確認を推奨しています(ベイジ)。こうした検索テクニックを使いこなすことで、AIの回答の裏付けを効率よく確認できます。
STEP3:複数の情報源で多角的に検証する
単一の情報源だけで判断せず、複数の独立した情報源が同じ内容を裏付けているかを確認することが、誤情報の見落としを防ぎます。特に数値や統計は情報源によって定義や調査時期が異なることが多いため、同一条件で比較できているかにも注意が必要です。
検証を効率化するツール・サービスの活用
すべての情報を人力で検証するのは現実的ではないため、ファクトチェックを支援するツールやサービスの活用も選択肢になります。NTT DATAは、AIと品質保証の視点を「QA4AI(AIが使われるソフトウェアの品質保証)」と「AI4QA(AIを活用した品質保証支援)」の2つに整理し、AIプロダクト品質保証ガイドラインや機械学習品質マネジメントガイドラインの存在を紹介しています(NTT DATA)。こうした枠組みを参考に、自社の業務フローに応じた検証体制を構築することが望まれます。
| STEP | 確認内容 | 具体的な手段 |
|---|---|---|
| STEP1 | 情報源の有無 | 出典・参照元の明記を確認 |
| STEP2 | 一次情報との照合 | site:go.jp、Google Scholar等で確認 |
| STEP3 | 複数情報源での検証 | 独立した複数ソースの内容一致を確認 |
| 補助 | 品質保証の枠組み活用 | QA4AI・AI4QAのガイドライン参照 |
TechSuite株式会社の「AI検索パートナーズ」は、技術的アプローチを担う人材とAIを活用したコンテンツ制作人材が一つのチームで連携し、戦略設計から検証・改善までを一気通貫で伴走できる体制を整えています。発信側と検証側の両方の観点を同じチームで担えることが特徴です。
AIの回答は便利な仮説として扱い、必ず一次情報で裏取りする姿勢が大切です
自社サイトがAIにどう引用されているか確認する方法
自社サイトの引用状況は、生成AIへの直接質問・AI経由流入の解析ツール・ブランド名の定点観測という3つの方法を組み合わせることで把握できます。引用状況を確認しないまま情報設計だけを進めても、効果検証ができず改善が進みません。
ChatGPT/Perplexity/Geminiで直接質問して確認する
最も手軽な方法は、自社の商品名やブランド名、関連するキーワードについてChatGPT・Perplexity・Geminiなど複数の生成AIに実際に質問し、自社サイトが引用されるか、内容が正しいかを確認することです。同じ質問でもAIごとに回答や引用元が異なることが多いため、複数のAIで確認することが望まれます。
AI経由のアクセス解析ツールで流入を計測する
アクセス解析においてAI検索経由の流入を区別して計測することで、施策の効果を定量的に把握できます。AI経由の流入は単なる露出ではなく、実際の受注や問い合わせにつながっているかまで追跡することが重要です。
ブランド名・商品名の検索でネガティブ情報の混入を定点観測する
ブランド名や商品名に関する質問をAIに投げかけ、事実と異なる情報や古い情報、ネガティブな内容が混入していないかを定期的に確認することも欠かせません。こうした継続的な監視はAI Reputation Managementと呼ばれる領域に位置づけられ、問題を早期に発見し訂正情報を発信する体制につながります。関連する用語の整理はAI検索対策の進め方でも紹介しています。
| 確認方法 | 把握できること | 頻度の目安 |
|---|---|---|
| 生成AIへの直接質問 | 引用の有無・内容の正確性 | 月1回程度 |
| AI経由流入の解析 | 流入数・受注への貢献度 | 常時(レポートは月次) |
| ブランド名の定点観測 | 誤情報・古い情報の混入 | 月1〜2回程度 |
TechSuite株式会社の「AI検索パートナーズ」は、露出や順位だけでなく受注という成果に直結させることを重視しています。自社でも対策を重ね、ChatGPTでの言及シェアは0.0%から20.0%、引用シェアは3.7%から35.3%に伸びました(調査対象44クエリ・比較19社中の構成比、2026年8月27日時点、自社調べ)。定点観測の結果を施策に反映させる運用まで一貫して支援できる点が強みです。
引用状況の定点観測を続けることで初めて改善のサイクルが回り始めます
よくある質問
- AIに一度引用されれば正確性は保証されるのか
保証されません。SourceCheckup研究では、Web検索付きのGPT-4oでも約30%の文が引用元によって裏付けられていなかったと報告されており(medicolle)、引用の有無と内容の正確性は別問題として継続的に確認する必要があります。
- 個人ブログやまとめサイトの情報はAIにどう扱われるのか
機関的な権威性や監修体制を持つ情報源と比べると、AIの引用ソースとして選ばれる割合は相対的に低い傾向があると報告されています。ただし独自の一次情報や体験に基づく内容であれば、専門性の高いテーマでなくても引用対象になり得るため、内容の独自性と検証可能性を高める工夫が有効です。
- ハルシネーションはRAGを使えば完全になくなるのか
完全にはなくなりません。RAGやグラウンディングは外部の信頼できるデータソースと照合して回答精度を高める技術ですが(Japan AI)、単一の対策では不十分とされ、ガードレールやハルシネーション検知モデルとの併用が効果的とされています(AI総研)。
- 自社に専門知識がなくてもAIO/LLMO対策は始められるのか
始められます。まずは本記事で紹介した情報設計チェックリストのように、結論ファーストの構成や更新日の明記など専門知識を要さない項目から着手し、専門性が問われる領域は外部の監修者やコンサルティングサービスと連携する形が現実的です。
まとめ
AI引用の正確性は、発信側の情報設計だけでも、利用側のファクトチェックだけでも担保しきれません。一次情報の明示や構造化データ、E-E-A-Tの明記といった7つの方法と、情報源の確認から複数ソースでの検証までの3ステップを組み合わせることが現実的なアプローチです。
あわせて、自社サイトがAIにどう引用されているかを定期的に確認する運用体制を持つことで、誤情報の早期発見と継続的な改善が可能になります。情報設計と検証プロセスの両輪を回し続ける姿勢が、AI検索時代における信頼構築の土台になるでしょう。
参考にした情報源